
ChatGPT는 인용할 페이지를 어떻게 선별할까? 디버그 데이터로 본 검색 파이프라인
- ChatGPT는 사용자 프롬프트 하나를 여러 하위 쿼리로 쪼개는 쿼리 팬아웃을 거쳐 검색 결과를 수집한 뒤, 본문을 약 170단어의 블록 단위로 채점하고 도메인 단위로 재배열하여 최종 인용 링크를 결정합니다.
- 실무자는 ChatGPT 노출과 최종 인용을 분리하여 측정하고, 크롤러 접근 허용부터 최신성 관리 및 하위 쿼리에 맞춘 독립적 블록 단위 콘텐츠 구성까지 단계별 탈락 지점에 맞춰 대응하기를 권장합니다.
공개된 한 관측 사례에서 ChatGPT는 "best AI visibility tools"라는 프롬프트 하나에 검색 엔진을 50회 호출해 검색 결과 228건을 수집했고, 그중 16건의 링크를 인용했습니다. 이 수치는 ChatGPT 웹 UI의 SSE(Server-Sent Events) 응답에 포함된 디버그 필드에서 확인된 것으로, Peec AI의 GEO 연구자 Metehan Yeşilyurt가 LinkedIn을 통해 공개했습니다. 이 글은 해당 공개 자료와 필자가 직접 수집한 SSE 응답을 바탕으로 ChatGPT의 검색 파이프라인을 단계별로 정리하고, 단계마다 실무적 시사점을 짚습니다.
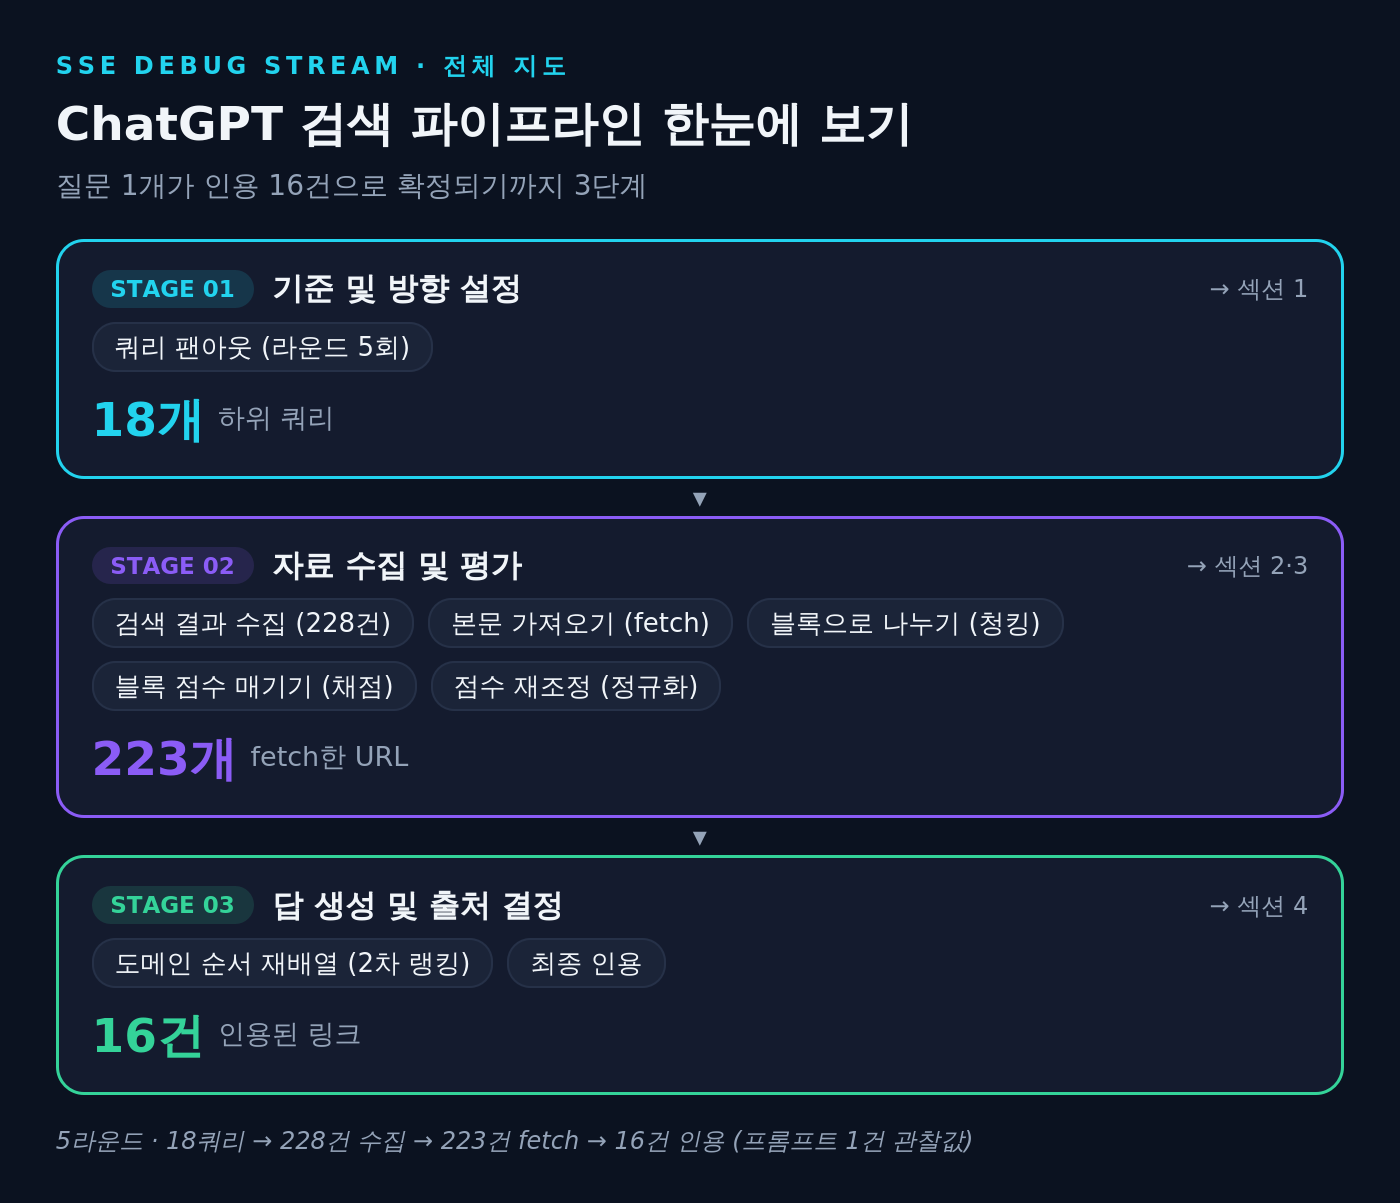
ChatGPT는 "best AI visibility tools" 프롬프트 1개를 받아 이런 단계를 거쳐 답변의 근거를 정했습니다.
- 쿼리 팬아웃: 프롬프트 1개에 대해 검색 라운드 5회, 하위 쿼리 18개, 엔진 호출 50회가 기록되었습니다.
- 검색 결과 수집과 fetch: 검색 결과 228건을 모으고, 그중 223개 URL의 본문을 가져옵니다.
- 청킹과 채점: 가져온 페이지의 본문은 약 170단어 블록(청크) 단위로 점수가 매겨집니다.
- 2차 랭킹과 최종 인용: 답변이 쓰이기 전에, 모델의 추론 과정에서 도메인 순서를 한 번 더 재배열하고, 인용된 링크는 16건입니다.
이 글은 위 과정을 기준·방향 설정(1), 자료 수집·평가(2·3), 답변 생성·출처 결정(4)의 세 단계로 나누어 살펴봅니다.
분석에 앞서 데이터의 한계를 밝혀 둡니다. SSE 디버그 필드는 OpenAI 공식 문서가 아니라 ChatGPT 웹 UI(API 제외)의 응답에서 포착된 비공개 데이터이며, 상세 필드를 다룬 자료는 모두 한 연구팀의 관측에 기반합니다. 또한 ChatGPT 검색은 Statsig 기반 A/B 테스트와 Instant·Medium·High 설정에 따라 구성이 달라지므로, 계정과 관측 시점에 따라 같은 필드가 재현되지 않을 수 있습니다. 본문에서는 공개된 기록과 필자가 수집한 응답에서 확인된 내용은 단정형으로, 그에 대한 필자의 해석은 '~로 봅니다'로 구분해 적습니다.
독립적인 교차 확인 사례도 있습니다. The GEO Lab 창업자 Artur Ferreira는 자신의 도메인으로 수집한 SSE 스트림에서도 쿼리 팬아웃, 청크 단위 스코어링, 약 170단어 블록 구조가 동일하게 관찰되었다고 밝혔으나, 2026년 9월 8일 11시(UTC)경 해당 필드가 자신의 계정에서 사라졌다고 덧붙였습니다. 필자가 수집한 SSE 응답에서도 하위 쿼리와 검색 결과 목록은 확인되었지만, 단계별 스코어링을 담은 상세 디버그 필드는 노출되지 않았습니다.
1. [Stage 01] 질문 1개가 18개로 쪼개지는 '쿼리 팬아웃'
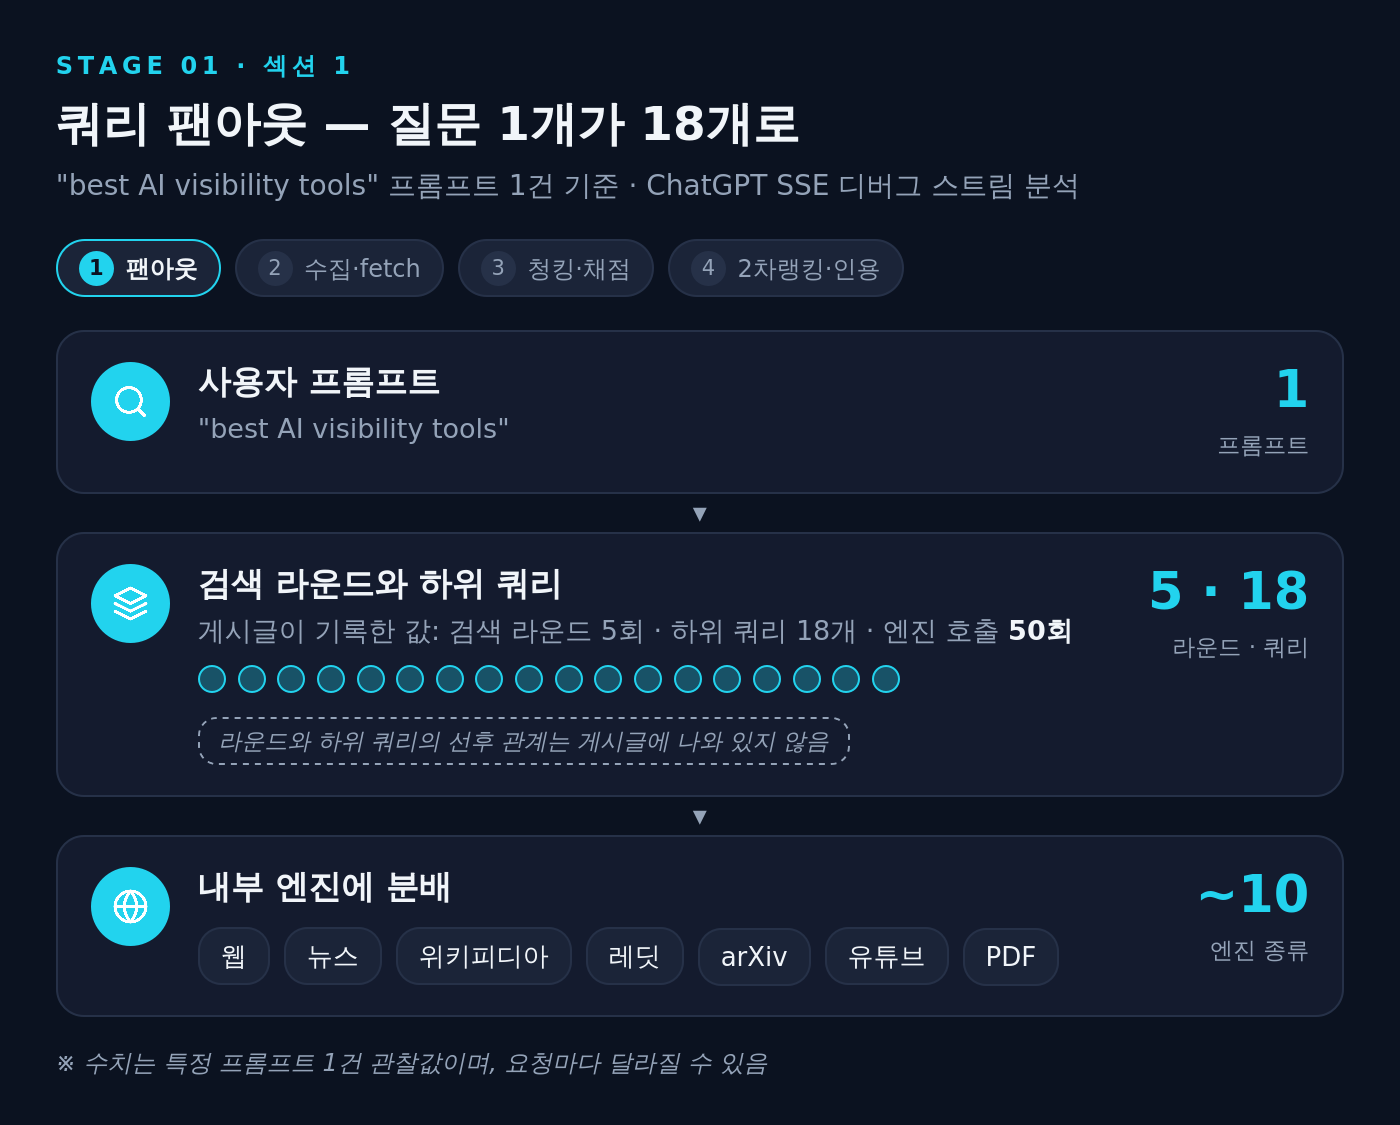
ChatGPT 검색 파이프라인의 첫 단계는 쿼리 팬아웃입니다. 프롬프트 1개를 여러 하위 쿼리로 나누어 검색합니다. 게시글의 SSE 응답에는 "best AI visibility tools" 프롬프트 1개에 대해 검색 라운드 5회, 하위 쿼리 18개, 엔진 호출 50회가 기록되어 있고, 하위 쿼리마다 약 10종의 내부 검색 엔진(웹·뉴스·위키피디아·레딧·arXiv·유튜브·PDF 등) 중 어디로 보냈는지도 함께 남아 있습니다. 다만 18개 하위 쿼리의 문장은 공개되어 있지 않아, 실제 모양은 두 가지 다른 사례로 확인합니다.
사례 1. Peec AI의 헤드폰 비교 실험
Peec AI의 헤드폰 비교 실험에서 하위 쿼리 한 건이 공개되어 있습니다. 이 실험의 질문은 300달러 이하 무선 노이즈 캔슬링 헤드폰 가운데 Sony WH-1000XM5, Bose QuietComfort Headphones, Sennheiser Momentum 4를 비교해 달라는 것이었습니다. ChatGPT는 웹 검색을 4회 했습니다. 그중 한 검색의 쿼리가 "best noise cancelling headphones under $300 2026 Sony WH-1000XM5 Bose QuietComfort Momentum 4"였습니다. 질문의 제품명이 일부 줄어든 채 남고, 질문에 없던 연도(2026)가 붙었으며, 검색 범위는 rtings.com, tomsguide.com, soundguys.com 세 사이트로 제한되어 있었습니다.
사례 2. 필자가 수집한 7개 쿼리
두 번째 사례는 필자가 직접 수집한 SSE 응답(gpt-5-6-thinking 모델)입니다. 같은 "best AI visibility tools" 프롬프트의 하위 쿼리 7개를 볼 수 있었고, 게시글의 18개와는 별개의 실행입니다. 7개는 검색 도구(web.run) 호출 기록 한 건에 담겨 있었습니다.
- best AI visibility tools GEO AEO ChatGPT Perplexity AI Overviews 2026
- Profound AI visibility platform pricing features ChatGPT Perplexity Google AI Overviews
- Peec AI search visibility platform pricing features
- Otterly AI visibility monitoring pricing features
- Scrunch AI search visibility platform features pricing
- Ahrefs Brand Radar AI visibility features ChatGPT Perplexity AI Overviews
- Semrush AI Visibility Toolkit features pricing
첫 번째는 원래 프롬프트에 GEO, AEO, 2026 같은 말을 덧붙인 형태입니다. 나머지 여섯 개는 Profound, Peec AI, Otterly, Scrunch, Ahrefs Brand Radar, Semrush라는 도구 이름에 features를 붙인 형태이고, 다섯 개는 pricing도 포함합니다.
이 응답에는 상세 디버그 필드가 없어서 일곱 개가 한 묶음으로만 보입니다. 확인되지는 않지만, 내부적으로는 라운드를 나눠 첫 번째 쿼리의 검색 결과를 본 뒤 도구 이름의 쿼리가 이어졌다고 봅니다. 별개의 실행이지만 같은 프롬프트가 게시글에서 5회의 라운드로 기록된 점이 이 해석의 바탕입니다. 다만 도구 이름을 모델이 원래 알고 있었을 가능성도 있습니다.
두 사례를 나란히 놓고 보면 실무적 시사점이 세 가지 있습니다.
콘텐츠도 대표 키워드 하나가 아니라 하위 쿼리 모양에 맞춰 준비해야 합니다. 쿼리가 어떻게 만들어졌는지는 SSE 응답만으로 알 수 없지만, ChatGPT가 만든 하위 쿼리의 모양은 확인되기 때문입니다. 헤드폰 실험에서는 질문의 제품명과 가격 조건에 연도(2026)가 붙었고, 필자가 확인한 응답에서는 질문에 브랜드가 없었는데도 도구 이름 여섯 개가 features와 함께 쿼리에 들어갔습니다. 두 경우 모두 일반 키워드 하나가 아니라 이름과 조건이 붙은 쿼리로 봅니다.
비교·구매 질문에서는 일부 하위 쿼리가 특정 도메인으로 제한될 수 있습니다. 헤드폰 비교 실험에서는 웹 검색 4회 중 하나가 세 리뷰 사이트로 제한되어 있었습니다. 후보가 검색 단계에서 이미 그 사이트들로 좁혀진 셈이라, 자기 사이트의 콘텐츠뿐 아니라 이런 매체에서 다뤄지는지도 함께 살펴보기를 권장합니다.
한 번 측정한 하위 쿼리 규모로 전략을 세우면 안 됩니다. ChatGPT의 검색 규모가 질문과 실행마다 달랐기 때문입니다. 같은 "best AI visibility tools" 프롬프트의 하위 쿼리가 Peec AI 게시글에서는 18개, 필자가 확인한 SSE 응답(gpt-5-6-thinking 모델)에서는 7개였습니다. 헤드폰 비교 질문은 웹 검색 4회였습니다. 모델과 설정이 같다는 근거가 없어 원인은 알 수 없지만, 여러 번, 여러 설정으로 확인하기를 권장합니다.
2. [Stage 02-1] 자체 인덱스 'Labrador'와 fetch 대상 판정
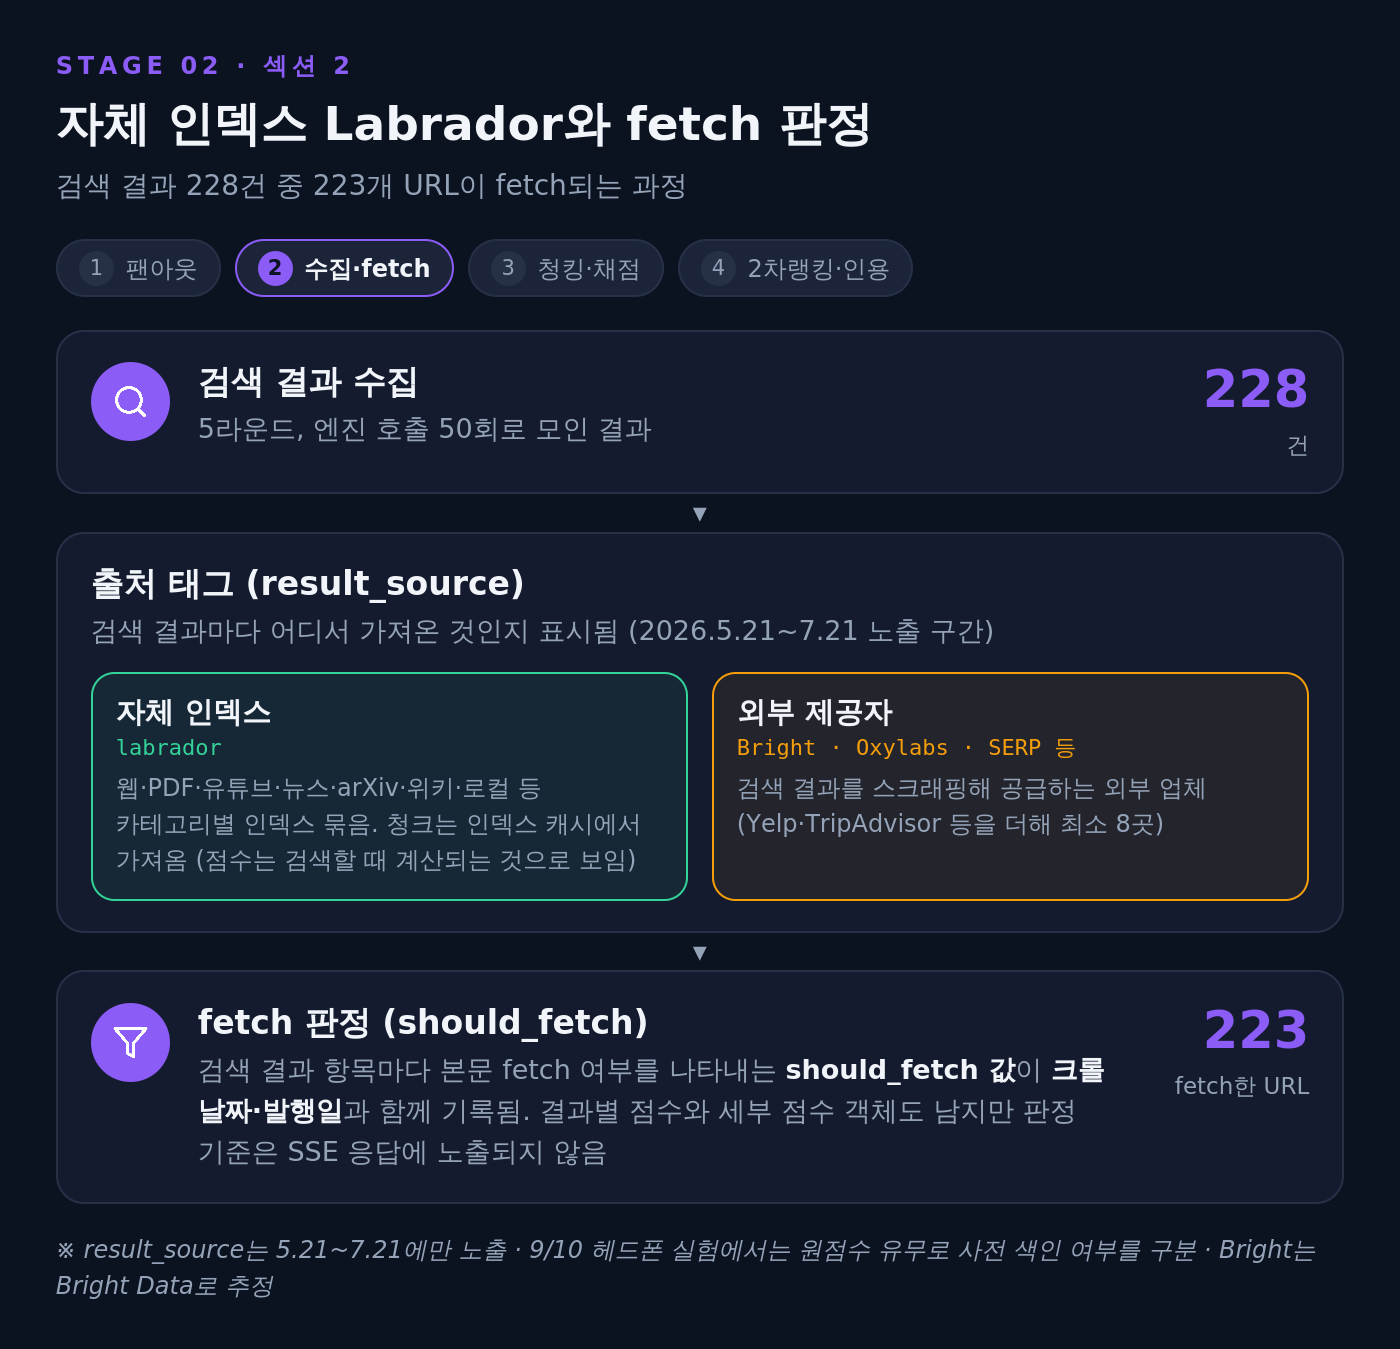
ChatGPT는 검색 결과 228건을 모은 뒤 그중 223개 URL을 fetch했습니다. fetch는 검색 결과에 나온 페이지의 본문을 실제로 가져오는 것을 말합니다. 검색 결과 항목마다 본문 fetch 여부를 나타내는 should_fetch 값이 크롤 날짜, 발행일과 함께 기록되고, 결과별 점수와 세부 구성 점수 객체도 남습니다. 다만 should_fetch를 어떤 기준으로 판정하는지는 SSE 응답에 노출되지 않습니다. 검색 결과에는 페이지의 메타 태그도 함께 실려 오는데, Open Graph 정보(og_data)는 모든 결과에서 비어 있었고 메타 태그 원본(raw meta_tags)만 유지되었습니다. 각 검색 결과가 어디서 가져온 것인지는 별도 필드로 구분됩니다.
검색 결과의 출처: result_source
Peec AI 블로그 글에 따르면 검색 결과가 어디서 가져온 것인지는 result_source 필드에서 알 수 있었습니다. 이 필드는 2026년 5월 21일부터 7월 21일까지 ChatGPT의 SSE 응답에 노출되었습니다. 값은 Labrador, Bright(Bright Data로 추정), Oxylabs, SERP 네 가지뿐이었습니다. Labrador는 OpenAI의 자체 인덱스이고, 나머지 셋은 외부 스크래핑 제공자입니다. 블로그 글은 여기에 Yelp, TripAdvisor, Microsoft Web IQ 등을 더해 외부 제공자를 최소 8곳으로 정리했습니다. 이 필드는 이후 SSE 응답에서 사라졌고, 하위 쿼리마다 기록되는 내부 엔진 배정과는 별개의 기록입니다. 다만 9월 10일에 공개된 헤드폰 실험에서는 사전 색인된 페이지에 원점수가 붙어 있어 구분되었고, 인덱스에 없던 페이지가 어느 제공자에서 왔는지는 알 수 없습니다.
자체 인덱스 Labrador: 12개 카테고리와 청크 캐시
ChatGPT의 자체 인덱스 Labrador는 하나의 인덱스가 아니라 카테고리별 인덱스의 묶음입니다. 확인된 카테고리는 웹, PDF, YouTube, 뉴스(최근 1일·최근 7일·그 이전으로 분리), arXiv, 위키피디아, 로컬, 금융(PDF용 인덱스 별도), 법률, 의료, 쇼핑, 이미지의 12개입니다. Labrador에는 페이지 전체 내용과 크롤 날짜, 발행일이 저장되어 있습니다.
Peec AI는 SSE 응답을 근거로, 이미 색인된 페이지의 청크는 ChatGPT가 새로 만들지 않고 검색 인덱스의 캐시에서 가져오는 것으로 분석합니다. 이런 페이지는 검색 결과 기록에 있던 청크와 신경망 관련성 점수가 fetch된 페이지 기록으로 이어지고(점수만 재조정됨), 색인되지 않았거나 새로 가져온 페이지는 실행 시점에 청크로 나뉩니다. 관련성 점수는 쿼리에 따라 달라지는 값입니다. 쿼리마다 미리 저장해 두기는 비효율적이니, 청크와 달리 검색할 때 계산되는 값으로 봅니다. 사전 색인된 페이지의 비중은 헤드폰 비교 실험에서 확인됩니다. ChatGPT가 가져온 96개 페이지 중 76개가 사전 색인된 Labrador 페이지였고, 나머지 20개는 원점수가 없는 새로 가져온 페이지였습니다. 이 실험에서는 가져온 페이지의 약 79%가 이미 ChatGPT의 인덱스에 있던 페이지였던 셈입니다.
Bing·Google 색인만으로 ChatGPT 노출이 보장되지 않습니다.
ChatGPT가 자체 인덱스 Labrador와 캐시를 두고 외부 제공자도 최소 8곳 함께 쓰기 때문이라는 것이 Peec AI의 설명입니다. 따라서 검색엔진이 아닌 ChatGPT 자체 캐시에 자기 사이트가 포함되어 있는지 파악하는 것이 중요한데, 이를 확인하는 방법으로 제안된 것이 lockdown 모드입니다. 실시간으로 웹 페이지를 열 수 없지만 오프라인이나 캐시된 결과는 돌려줄 수 있는 ChatGPT 설정인데, 이 모드로 주요 SEO 매체의 홈페이지를 물었을 때 ChatGPT는 실시간 접속이 아니라 캐시에서 답했습니다. 같은 방식으로 자기 사이트의 주요 페이지가 캐시되어 있는지도 확인할 수 있다는 것입니다. 이 캐시는 ChatGPT 자신의 캐시라고만 설명되어 있고, Labrador 인덱스와 같은 저장소인지는 확인되지 않았습니다.
3. [Stage 02-2] 청킹, 채점, 정규화
ChatGPT가 fetch한 223개 URL의 본문은 HTML이 아니라 마크다운 형태의 텍스트로 바뀌어 있습니다. 게시글은 변환 결과의 표기를 여러 변환 도구와 비교해, 파이썬 html2text 라이브러리와 가장 비슷하지만 수정 없는 표준 버전은 아니라고 했습니다. 이 텍스트는 청킹, 즉 약 170단어 블록(청크)으로 나뉘어 채점됩니다. 블록의 분할 경계와 오버랩 여부는 노출되지 않습니다.
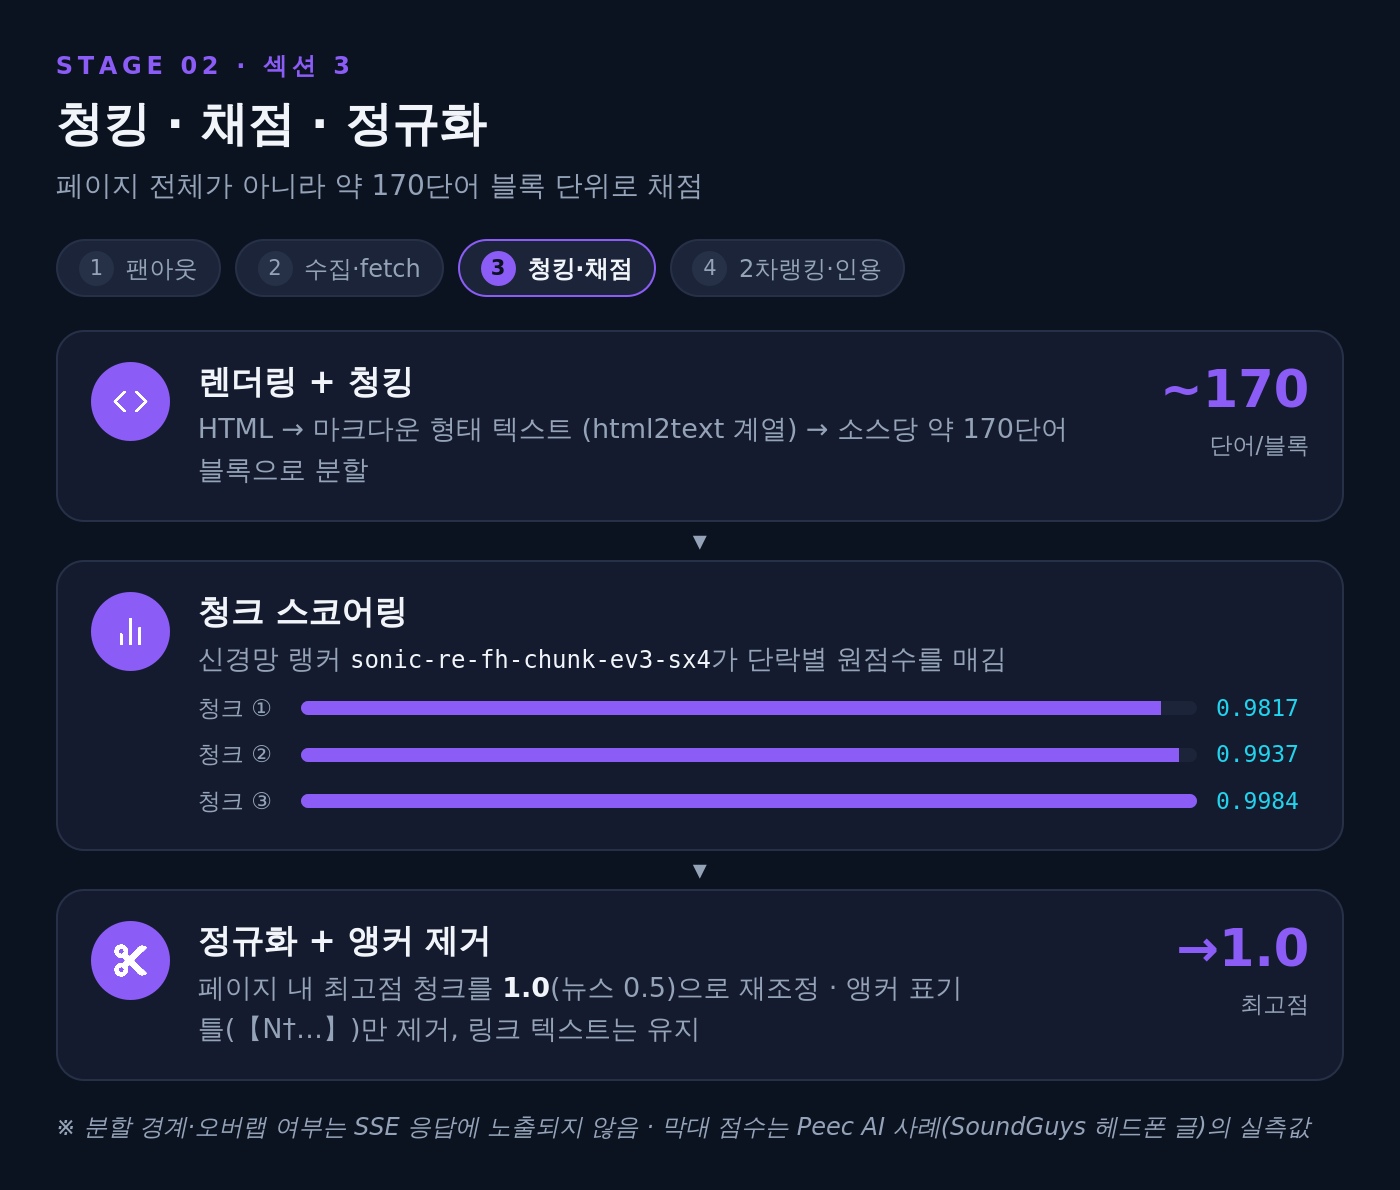
사전 색인된 페이지의 검색 결과 기록에서는 신경망 랭커 sonic-re-fh-chunk-ev3-sx4가 단락마다 원점수를 매겼습니다. 예를 들어 헤드폰 비교 실험에서 SoundGuys 페이지의 단락 3개는 0.9817, 0.9937, 0.9984를 받았습니다. 이 점수는 단락이 fetch된 페이지로 넘어갈 때 정규화, 즉 재조정되고 인용 표기도 바뀌는데, 정확한 계산식은 SSE 응답에서 보이지 않습니다. 같은 실험에서 확인된 변화는 이렇습니다.
- 최고점 청크의 점수: 사전 색인된 76개 페이지를 전수 대조한 결과, 웹·PDF·레딧·유튜브·위키피디아 결과는 1.0000(68개), 뉴스 결과는 0.5(8개)로 재조정됨. SoundGuys 단락의 원점수 0.9983865023은 1.0000이 됨
- 나머지 청크의 점수: 거의 같은 비율로 조정되어, 청크 사이 비율이 소수점 넷째 자리 정도까지 유지됨
- 인용 앵커 표기: SoundGuys 사례에서 【29†Our standard battery test】 같은 표기의 틀(【N†…】)만 제거되고 링크 텍스트는 유지됨
채점 단계의 점수는 페이지 전체가 아니라 블록 하나하나에 매겨지고, 페이지 안에서 가장 높은 블록이 기준이 되어 나머지가 재조정됩니다.
페이지 전체의 구성과 별개로, 질문에 단독으로 답이 되는 대표 답변 블록이 있어야 합니다.
검색 결과는 페이지 단위로 점수가 기록되지만, 그다음 채점은 블록 단위로 이뤄지기 때문입니다. 여기서 대표 답변 블록은 핵심 주장과 근거를 한 블록 안에 담은 블록을 뜻합니다. 블록이 어디서 잘릴지 알 수 없으니, 문단마다 하나의 주제를 담고 '앞서 말한 것처럼' 같은 앞 내용에 기대는 표현을 줄이는 것이 안전하다고 봅니다. 다만 어떤 블록 구성이 더 높은 점수를 받는지는 확인되지 않았습니다.
4. [Stage 03] 도메인 재배열(2차 랭킹)과 최종 인용
답 생성 및 출처 결정 단계에서 SSE 응답으로 확인되는 것은 2차 랭킹, 모델이 받는 프롬프트(사용자 질문이 아니라 모델의 입력), 인용 결과 세 가지입니다. 자료는 2차 랭킹을 먼저 나열하지만 처리 순서는 노출되지 않습니다.
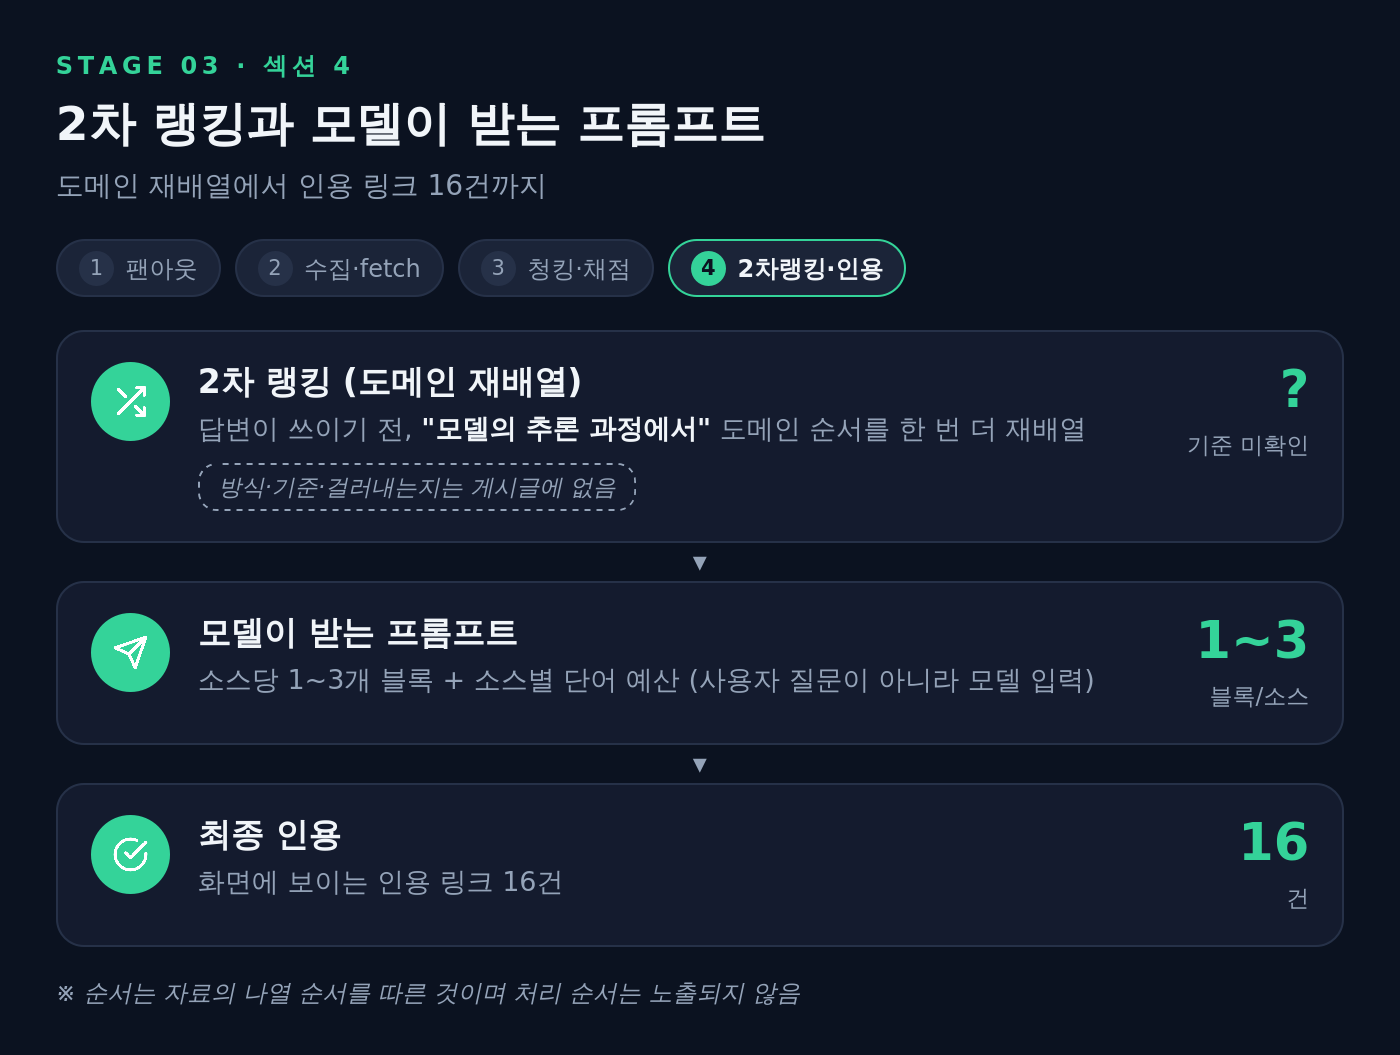
답을 쓰기 전, 모델의 추론 단계에서 도메인(사이트) 순서가 한 번 더 재배열됩니다(2차 랭킹). 재배열의 방식과 기준, 후보를 걸러내는지는 게시글에 공개되어 있지 않습니다.
모델이 받는 프롬프트에는 점수가 매겨진 블록 가운데 소스(가져온 페이지)당 약 170단어 블록 1~3개와 소스별 단어 예산이 기록되며, 이 예산은 각 소스가 쓸 수 있는 분량의 한도로 봅니다. 예산이 블록 수를 정하는지, 223개 URL이 모두 포함되는지는 공개되어 있지 않지만, 본문 전체가 아니라 선택된 블록만 전달된다는 점은 분명합니다.
마지막은 인용 결과입니다. "best AI visibility tools" 질문 1건에서 ChatGPT가 인용한 링크는 16건이고, 사용자 화면에도 16개 링크가 보입니다.
ChatGPT에서 검색 결과에 들어가는 것과 인용되는 것은 서로 다른 관문입니다.
"best AI visibility tools" 사례에서 ChatGPT는 검색 결과 228건을 모았지만 인용한 링크는 16건이었습니다. 그래서 검색 결과 포함과 최종 인용을 따로 측정해야 어느 단계에서 빠지는지 진단할 수 있습니다. 포함 여부는 SSE 응답의 검색 결과 목록에서, 인용은 화면의 링크에서 확인할 수 있습니다. 필자가 수집한 응답(하위 쿼리 7개)에서는 검색 결과 목록에 22개 도메인(URL 130개)이 있었고, 인용 링크는 그중 7개 도메인의 9건이었습니다. 다만 인용 링크가 없다고 해서 답변에서 빠졌다고 단정할 수는 없습니다. 다른 URL을 근거로 답변에 언급될 수 있기 때문입니다. 그래서 링크뿐 아니라 답변 본문에서 언급되는지도 함께 확인해야 합니다.
5. [마무리] ChatGPT 인용 안 되는 이유, 인용에서 빠지는 4가지 지점
확인된 파이프라인을 기준으로 인용에서 탈락할 수 있는 지점을 네 가지로 정리했습니다. 각 지점의 대응은 효과가 검증된 방법이 아니라 관측 결과에 기반한 권고입니다.
ChatGPT 인용에서 빠지는 첫 번째 지점은 검색 결과 미포착입니다. ChatGPT가 모은 검색 결과 228건에 페이지가 포함되지 않으면 이후 단계로 넘어가지 못합니다. 이 지점은 기존 SEO와 겹치지만, 기준이 대표 키워드 하나가 아니라 하위 쿼리라는 점이 다릅니다. 대응은 크롤러 접근에서 시작합니다. OpenAI 공식 문서에 따르면 검색용 크롤러 OAI-SearchBot을 막으면 ChatGPT 검색 답변에 표시되지 않고, robots.txt와 공개 IP 대역 허용을 안내합니다. 접근을 연 뒤에는 하위 쿼리 모양의 검색어로 잡힐 만한 주제를 페이지가 다루게 하는 것을 권장합니다.
두 번째 지점은 should_fetch 단계의 탈락입니다. 판정 기준은 공개되어 있지 않습니다. 다만 판정 값이 크롤 날짜·발행일과 함께 기록되고, 하위 쿼리에 현재 연도가 붙은 사례가 있고, 뉴스 인덱스가 최근 1일·7일 단위로 분리된다는 점에서 최신성 신호가 반영될 가능성이 있다고 봅니다. 발행일을 페이지에 명시하고 핵심 페이지를 주기적으로 갱신하는 것을 권장합니다.
세 번째 지점은 청크 점수 미달입니다. 가져온 페이지의 약 170단어 블록이 낮은 점수를 받는 경우입니다. 대응으로는 하위 쿼리 모양에 맞춰 각 블록이 질문에 단독으로 답이 되도록 주장과 근거를 한 블록 안에 쓰고, 문단이 앞 내용에 기대지 않게 하는 것을 권장합니다.
네 번째 지점은 2차 랭킹 탈락입니다. 재배열 기준이 노출되지 않아 직접적인 대응 방법은 없습니다. 다만 재배열이 도메인 단위로 이뤄지고, 헤드폰 사례처럼 검색 단계에서도 범위가 특정 매체로 제한된 경우가 있어 도메인 단위 판단은 두 단계에서 확인됩니다. 이 점에서 사이트 신뢰도가 영향을 줄 수 있다고 보며, 자사 사이트 외에 신뢰도 높은 외부 매체에서 다뤄지는 것도 대응이 될 수 있습니다.
정리하면 ChatGPT는 쿼리, 블록, 도메인으로 판단 단위를 바꿔 가며 후보를 선별합니다.
쿼리 단위로 흩어 찾고(쿼리 팬아웃), 블록 단위로 점수를 매기고(청킹과 채점), 도메인 단위로 순서를 다시 정합니다(2차 랭킹). 이 중 검색 결과에 드는 첫 단계는 SEO와 겹치는 영역이고, 블록과 도메인 단위 판단은 그 뒤에 더해지는 영역이라고 봅니다. 콘텐츠 쪽에서 손볼 수 있는 것은 접근 허용, 최신성 관리, 하위 쿼리에 맞춘 블록 작성이고, 도메인 재배열은 기준이 공개되지 않은 영역입니다. 그래서 먼저 노출과 인용을 따로 측정해 어느 지점에서 빠지는지 보는 것이 출발점이라고 봅니다.
이 글의 분석은 공개된 SSE 관측 기록과 필자가 수집한 응답에 기반하며, 파이프라인 전체를 재현한 것은 아닙니다. 디버그 필드는 계정과 시점에 따라 노출 여부가 달라지므로, SSE 응답을 지속적으로 수집해 확인되지 않은 구간을 보완해 나가야 합니다.
이 글의 내용을 실무에 옮길 때 아티언스가 가장 중요하게 보는 지점은 '단독으로 완결되는 블록 단위 콘텐츠 설계'입니다. ChatGPT는 페이지 전체의 흐름보다 약 170단어 내외의 청크 단위로 점수를 매기기 때문에, 앞 내용에 의존하지 않고 하나의 문단 안에서 핵심 주장과 근거가 완결되도록 작성하는 것이 안전하다고 봅니다.
또한 본문이 강조하는 쿼리 팬아웃은 사용자의 단순한 질문이 시스템 내부에서 구체적인 브랜드, 조건, 연도가 결합된 다수의 정교한 하위 쿼리로 확장되는 메커니즘을 보여줍니다. 이는 기업이 단일 대표 키워드 중심의 최적화에서 벗어나, 소비자가 비교·탐색 과정에서 마주할 구체적인 조건 조합에 맞춰 콘텐츠를 다각화할 필요가 있음을 시사합니다.
결국 ChatGPT 검색 최적화는 '단순한 키워드 매칭'이 아니라 '인공지능의 다단계 추론 파이프라인에 부합하는 정보 구조화'에 가깝습니다. 아티언스는 앞으로도 관측 사례를 계속 확인하며 이 글을 보완하겠습니다.
자주 묻는 질문
ChatGPT는 검색 결과를 가져올 때 Google이나 Bing의 색인만 사용하나요?
아니요. ChatGPT는 자체 인덱스인 'Labrador'와 캐시를 보유하고 있으며, Bright Data나 Oxylabs를 포함한 최소 8곳의 외부 스크래핑 제공자를 함께 사용합니다.
우리 사이트가 ChatGPT 자체 캐시에 들어있는지 확인하는 방법이 있나요?
네, 실시간 웹 접속 없이 오프라인이나 캐시된 결과로 답하는 'lockdown' 설정을 활용해 자사 페이지를 질문함으로써 캐시 저장 여부를 확인할 수 있습니다.
본문이 길고 상세할수록 ChatGPT 검색에서 인용될 확률이 높아지나요?
아니요. ChatGPT는 페이지 전체가 아니라 약 170단어의 블록 단위로 나누어 채점하므로, 문단마다 질문에 단독으로 답이 되는 대표 답변 블록을 갖추는 것이 더 중요합니다.
검색 결과 목록에 우리 URL이 포함되었다면 답변에 인용된 것과 다름없나요?
아니요. 검색 결과 수집과 최종 인용은 서로 다른 관문이며, 수백 건의 검색 결과 중 단 16건만 인용되는 사례처럼 최종 인용 단계에서 탈락할 수 있으므로 두 지표를 분리해 측정해야 합니다.
ChatGPT 검색 최적화를 처음 도입할 때 무엇부터 해야 하나요?
가장 먼저 OpenAI의 검색용 크롤러인 'OAI-SearchBot'의 접근을 robots.txt와 공개 IP 대역 허용을 통해 열어두어야 합니다.
참고 자료
LinkedIn (Metehan Yeşilyurt, Peec AI) — ChatGPT retrieval system LEAK alert https://www.linkedin.com/posts/metehanyesilyurt_chatgpt-retrieval-system-leak-alert-activity-7502755979411881984-MSCU
LinkedIn (Metehan Yeşilyurt, Peec AI) — ChatGPT retrieval system LEAK alert PART 2 https://www.linkedin.com/posts/metehanyesilyurt_chatgpt-retrieval-system-leak-alert-part-activity-7503484264269783040-pejJ/
LinkedIn Pulse (Metehan Yeşilyurt) — Inside the ChatGPT Leak: How ChatGPT Ranks Chunks From Fetched Pages [CHUNKING PROOF] https://www.linkedin.com/pulse/inside-chatgpt-leak-how-ranks-chunks-from-fetched-pages-ye%C5%9Filyurt--qrsyf/
Peec AI (Tomek Rudzki) — ChatGPT built its own search index https://peec.ai/blog/chatgpt-built-its-own-search-index
OpenAI — Overview of OpenAI Crawlers https://developers.openai.com/api/docs/bots