
AI에게 다 맡겨도 될까? DMEXCO 2026에서 찾은 답
- DMEXCO 2026에서 마케팅 전반에 AI 활용이 급증함과 동시에, 자율형 AI 에이전트의 예산 낭비 문제와 데이터 검증의 중요성이 핵심 과제 중 하나로 제시되었습니다.
- 마케터는 AI 유입과 측정 신호를 점검해야 합니다. 그리고 같은 일을 AI에게 맡겼는데 비용이 30배 가까이 벌어진 이유를 따라가면, 마케터가 지금 해야 할 일이 보입니다.
AI에게 다 맡겨도 될까?
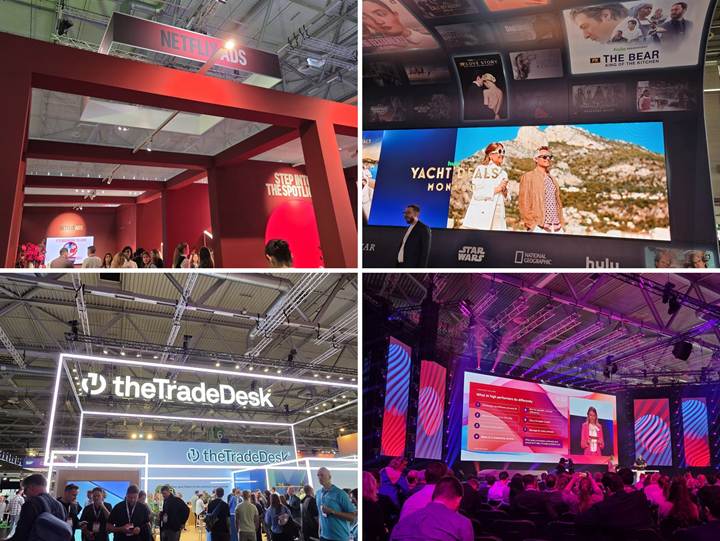
DMEXCO 첫날 들은 세션 중 퍼포먼스 마케팅 컨설턴트로서 가장 기억에 남는 건 pi-optimal의 'The Agentic Illusion'이었습니다. 발표자는 AI 에이전트가 구글 광고 계정의 지난 30일 데이터를 읽고 "타겟 CPA를 올리세요", "모바일 입찰이 저평가돼 있습니다" 같은 운영 판단까지 내리는 화면을 보여주었습니다. 이전에 제가 고객사 계정을 진단하고 수정할 때 했던 일과 거의 같은 흐름이었습니다.
여기까지만 보면 결론은 단순해 보였습니다. 이제 AI에게 맡기면 됩니다. 그런데 발표의 마지막 슬라이드는 정반대의 이야기를 하고 있었습니다. 같은 일을 맡겼는데 방식에 따라 비용이 30배 가까이 벌어졌다는 것입니다.
솔직히 그 자리에서는 왜 그런지 바로 와닿지 않았습니다. 답은 그 세션의 나머지 슬라이드와, 이틀 동안 들은 다른 세션들 속에 조금씩 흩어져 있었습니다.
어느 무대에 앉아도 AI 이야기였습니다
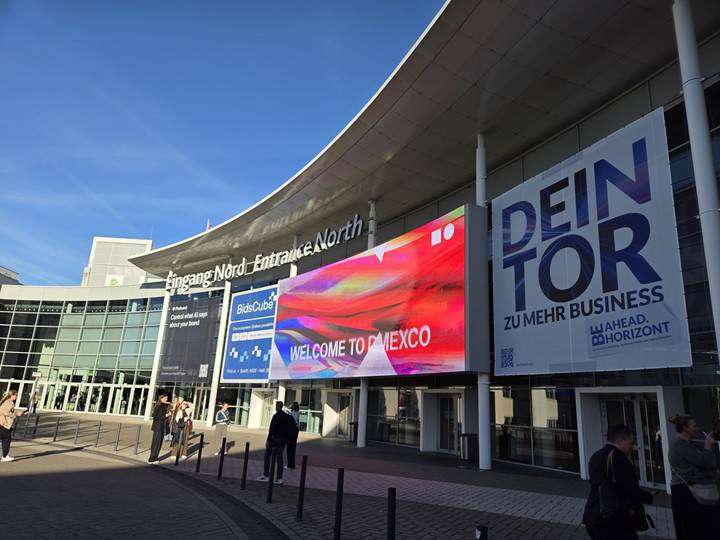
DMEXCO는 매년 쾰른에서 열리는 유럽의 대표적인 디지털 마케팅 행사입니다. 올해는 9월 23~24일 이틀간 열렸고, 주최 측 발표로는 방문객 4만 명 이상에 연사 약 1,000명, 스테이지 17개, 콘텐츠 230시간이 넘었습니다.
저는 이틀간 스무 개 가까운 세션을 듣고 부스를 돌았습니다. 검색, 커머스, 고객 경험, TV 광고까지 무대는 달랐지만 이야기는 매번 AI로 돌아왔습니다. 한두 회사가 아니라 시장 전체가 동시에 실험하고 있다는 게 피부로 느껴졌습니다.
올해 슬로건은 'Scaling Intelligence'였습니다. 주최 측 설명을 빌리면, AI를 시험해 보는 단계는 끝났고 이제는 조직 전체에서 실제 성과를 내야 한다는 말입니다. 그리고 그 성과를 평가하고 방향을 잡는 건 여전히 사람의 판단이라는 뜻도 담겨 있습니다.
이틀간 여러 세션에서 확인한 변화를 세 가지로 나눠 정리했습니다.
① 브랜드를 고르는 자리에 AI가 먼저 있었습니다
첫날 오전 센터 스테이지에서는 Microsoft와 Google이 연달아 발표했습니다. 두 회사가 같은 이야기를 다른 각도에서 했습니다. 소비자가 브랜드를 찾고 비교하는 과정이 검색 결과 목록에서 AI의 답변으로 옮겨가고 있다는 것입니다.
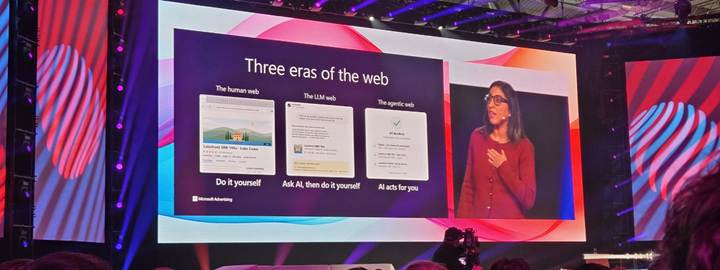
Microsoft Advertising의 Nidhi Ghai는 웹을 세 시대로 나눴습니다. 직접 찾는 시대(Do it yourself), AI에게 묻고 내가 고르는 시대(Ask AI, then do it yourself), AI가 대신 움직이는 시대(AI acts for you)입니다.
세 번째 시대에는 에이전트가 사람보다 먼저 비교하고 검증해서 후보를 추립니다. 그래서 그는 브랜드 스토리만큼이나 AI가 믿고 가져갈 수 있는 정보, 즉 가격·리뷰·스펙 같은 신뢰 정보를 잘 정리해 두는 일이 중요해진다고 말했습니다.
이 이야기가 아직 먼 미래는 아닙니다. Microsoft Clarity가 2025년 11월 공개한 분석을 보면, 1,200여 개 매체 사이트에서 AI 플랫폼을 통해 들어온 방문은 8개월 동안 155.6% 늘었습니다. 아직 전체 방문의 1%도 안 되는 작은 비중이지만, 회원가입 전환율은 1.66%로 일반 검색 유입(0.15%)의 열 배가 넘었습니다. 양은 작아도 AI가 한 번 걸러서 보낸 방문자는 이미 구매나 가입에 훨씬 가까운 상태였습니다.
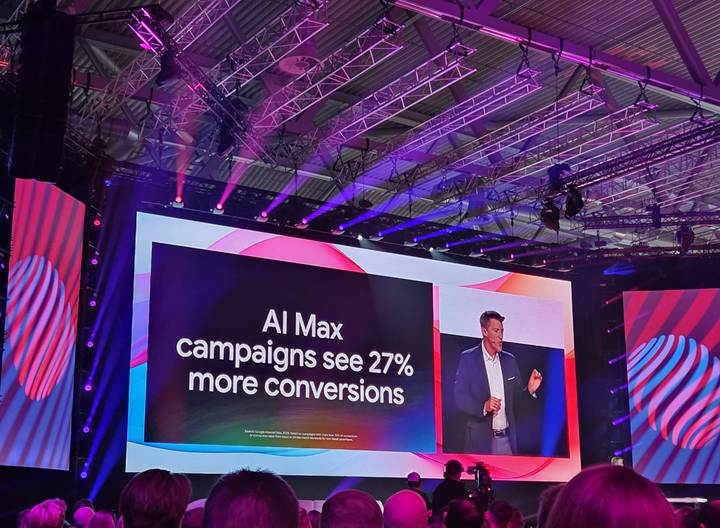
바로 이어진 Google의 Dan Taylor는 이 변화를 숫자로 보여줬습니다. AI Overviews의 월간 사용자는 25억 명을 넘었고, AI Max 캠페인은 전환이 27% 더 많았다는 슬라이드가 크게 띄워졌습니다. 검색 광고가 키워드를 사는 일에서 AI가 대화 속 의도를 읽고 광고를 고르는 일로 바뀌고 있는 셈입니다.
여기까지 듣고 제 업무에 바로 대입해 봤습니다. "AI가 우리 브랜드를 어떤 말로 소개하는가"는 이미 업계의 화두입니다. 그런데 이번에 들은 이야기와 숫자를 나란히 놓고 보니, 이건 검색 순위 옆에 곁들여 보는 참고 지표가 아니었습니다. AI를 거쳐 온 방문자의 전환율이 검색의 열 배라면, AI가 우리 브랜드를 소개하는 한 줄이 검색 순위만큼 성과를 좌우할 수 있습니다. 다만 검색 순위는 한 번 확인하면 되지만, AI의 답변은 질문과 시점마다 달라집니다. 한 번 물어보는 것으로는 부족하고, 꾸준히 묻고 기록해야 흐름이 보입니다.
② 그 숫자, 누가 채점했나요
그런데 돌아와서 이 27%를 Google 공식 블로그에서 다시 찾아보니 조건이 붙어 있었습니다. AI Max를 켜면 보통은 비슷한 CPA·ROAS에서 전환이 14% 늘고, 27%는 정확 일치·구문 일치 키워드 비중이 높은 캠페인에서 나온 수치였습니다. 둘 다 Google 내부 데이터입니다.
거짓말은
아니지만, 무대에는 더 큰 숫자가 조건
없이 올라간 셈입니다. 퍼포먼스 데이터를
분석하는 사람이라면 이런 숫자를 볼 때 늘 같은 질문을 하게
됩니다. 이건 누가, 어떤 조건에서 채점한 걸까?
새 광고 채널이 먼저 꺼낸 '제3자 측정'
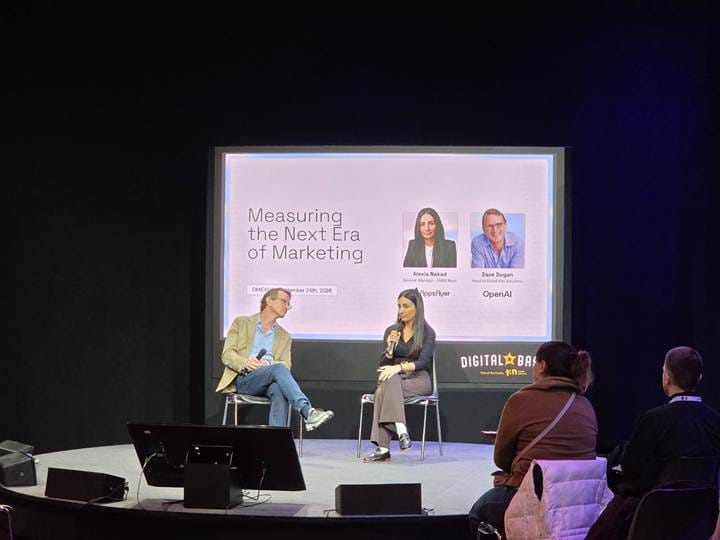
이 질문에 가장 직접적으로 답한 사람은 뜻밖에도 OpenAI였습니다. 둘째 날 AppsFlyer와의 대담에서 OpenAI의 Dave Dugan은 ChatGPT 광고를 내놓으며 "자기 숙제를 자기가 채점하지 않겠다(grading our own homework)"고 말했습니다. 자체 광고 관리 화면에서 노출과 클릭, CPC를 보여주긴 하지만, 그것만으로는 마케터의 신뢰를 얻기 어렵다는 것입니다. 마케터는 예산을 옮길 때 채널끼리 비교해야 하고, 그러려면 중립적인 제3자 측정이 필요합니다. 그래서 출시 초기부터 AppsFlyer를 포함해 50곳이 넘는 측정·기술 파트너와 연동했다고 합니다.
새 광고 채널이 출시 초기부터 "우리 숫자만 믿지 말라"고 말하는 건 흔한 일이 아닙니다. 그만큼 AI 채널의 성과를 증명하는 일이 앞으로 마케터에게 중요한 숙제가 된다는 신호로 읽었습니다. 그가 마케터에게 남긴 조언도 같은 맥락이었습니다. 작게 시작하되, CFO에게 ROI를 증명하려면 어떤 고객 행동을 성과로 볼지부터 정하라는 것입니다.
이건 독일만의 이야기도 아닙니다. OpenAI가 행사 첫날인 9월 23일 발표한 내용에 따르면 ChatGPT 광고는 이미 60개국 이상에서 운영되고 있고, 한국도 일본·호주·인도와 함께 먼저 출시된 시장에 포함돼 있습니다. 광고는 무료(Free)와 Go 요금제 이용자에게 노출되고, 출시 200일이 채 안 돼 연환산 매출 10억 달러를 넘겼다고 합니다. 한국 마케터에게도 'ChatGPT 광고를 해볼까'는 이미 현실의 질문이고, 그렇다면 '그 성과를 무엇으로 잴 것인가'도 함께 준비해야 합니다.
사람이 아닌 트래픽이 늘고 있습니다
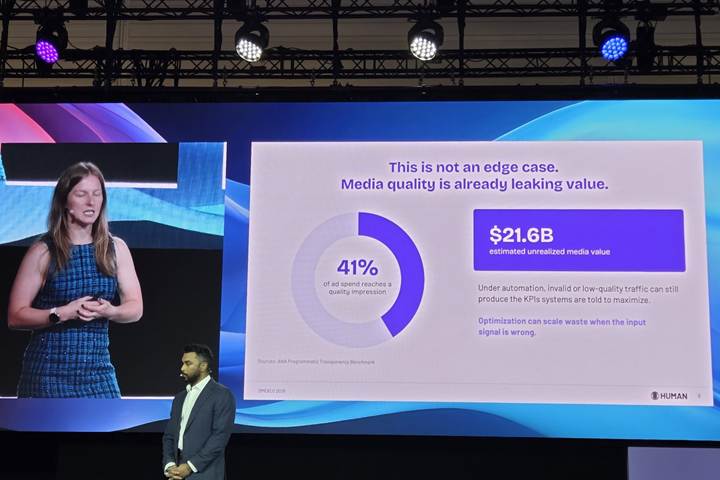
숫자를 의심해야 하는 이유는 하나 더 있습니다. 첫날 HUMAN Security 세션의 제목은 "Human, Bot or AI? Can You Trust Your Performance Data?"였습니다. 슬라이드에는 이런 문장이 있었습니다. "자동화 환경에서는 무효 트래픽이나 저품질 트래픽도 시스템이 극대화하도록 설정된 KPI를 만들어낼 수 있다. 입력 신호가 잘못되면 최적화는 낭비를 키운다." 이들은 이렇게 새는 미디어 가치를 216억 달러로 추정했습니다.
HUMAN Security가 올해 낸 리포트를 보면 이 경고가 과장이 아닙니다. 2025년 한 해 동안 AI로 움직이는 트래픽은 187% 늘었고, 그중 에이전트 트래픽은 전년 대비 7,851% 증가했습니다. 자동화 트래픽이 사람의 트래픽보다 8배 빠르게 늘고 있다는 것입니다. 우리가 보는 방문과 클릭 중 사람이 아닌 몫이 점점 커지고 있습니다.
결국 AI가 낸 숫자를 채점하는 일까지 플랫폼에 맡길 수는 없습니다. 그리고 이 경고는 에이전트 이야기와 바로 맞닿아 있습니다. 에이전트가 읽고 판단하는 대상이 바로 이 데이터이기 때문입니다.
③ 에이전트는 돌리되, 레일 위에서
다시 pi-optimal 세션입니다. 계정 진단까지 해내는 에이전트를 보여준 뒤, 발표자가 마지막에 띄운 슬라이드의 제목은 "Agents will burn your budget"이었습니다. 에이전트가 예산을 태운다는 경고입니다.
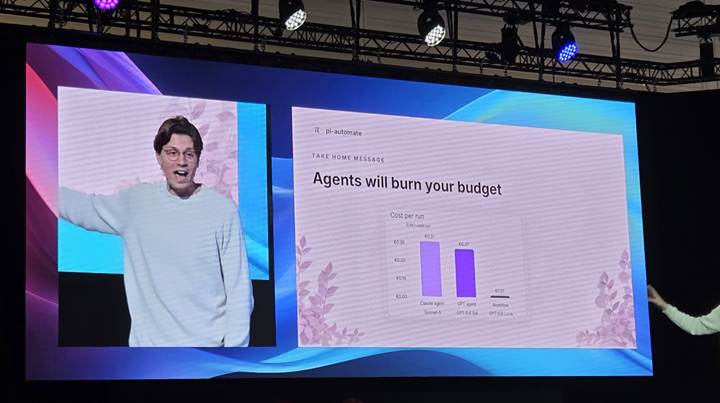
문제는 비용과 일관성이었습니다. 발표자가 제시한 유효한 실행 1회당 비용을 원화로 바꾸고, 광고 계정 100개를 매일 한 번씩 점검한다고 가정해(한 달 3,000회) 월·연 비용으로 늘려 보면 이렇습니다.
|
방식 |
모델 |
1회 실행 |
한 달 |
1년 |
|
Claude 기반 에이전트 |
Claude Sonnet-5 |
약 465원 |
약 140만
원 |
약 1,670만
원 |
|
GPT 기반 에이전트 |
GPT-5.6 Sol |
약 405원 |
약 122만
원 |
약 1,460만
원 |
|
워크플로 |
GPT-5.6 Luna |
약 15원 |
약 4만 5천
원 |
약 54만
원 |
비용만의 문제도 아닙니다. 자율형 에이전트는 실행할 때마다 판단 경로가 달라 결과가 들쭉날쭉하고, 그걸 사람이 다시 검증하는 시간까지 더해집니다.
에이전트와 워크플로, 무엇이 다른가
여기서 워크플로는 사람이 미리 정해 둔 순서대로만 움직이는 방식입니다. 에이전트는 목표만 받으면 무엇을 볼지, 어떤 순서로 할지를 스스로 정하면서 모델을 여러 번 부릅니다. 반면 워크플로는 '데이터를 뽑는다 → 기준과 비교한다 → 넘으면 알린다'처럼 단계가 고정돼 있고, AI는 그중 필요한 칸에만 들어갑니다.
눈여겨볼 건 모델이었습니다. GPT 에이전트는 GPT-5.6 계열의 최상위 모델인 Sol을 썼고, 워크플로는 같은 계열에서 가장 작고 저렴한 Luna를 썼습니다. 할 일과 순서가 정해져 있으면 가장 비싼 모델이 필요 없고, 작은 모델로도 충분히 굴러갑니다. 비용 차이의 상당 부분이 여기서 나왔습니다.
한 번에 400~500원이면 대수롭지 않아 보입니다. 하지만 표에서 보듯 계정 100개를 매일 점검하는 규모만 돼도, 같은 일을 하는데 1년에 천만 원 넘게 차이가 납니다. 계정과 점검 횟수가 늘수록 그 차이도 그대로 커지고, 여기에 결과를 다시 확인하는 사람의 시간은 들어가지도 않았습니다.
(위
계산은 발표 수치를 바탕으로
한 예시이며, 실제
비용은 모델과 작업
범위에 따라 달라집니다. 원화는 1유로 = 약 1,500원
기준으로 환산했습니다.)
해법: AI on rails
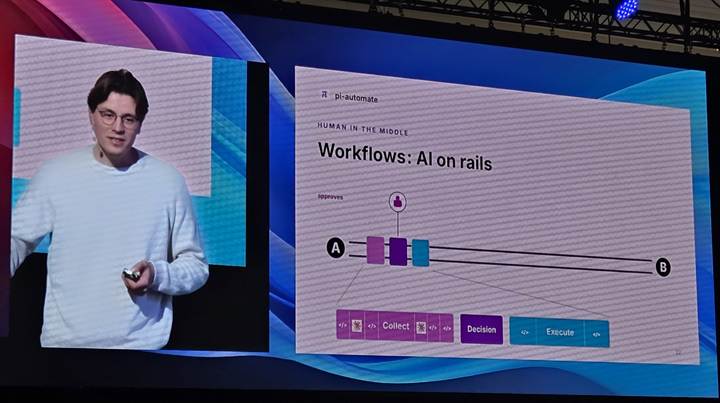
그래서 그가 내놓은 답이 'AI on rails'입니다. 데이터를 모으는 단계(Collect)와 실행하는 단계(Execute)는 AI가 맡고, 그 사이의 결정(Decision)은 사람이 승인합니다. 에이전트를 쓰지 말자는 게 아니라, 어디까지 맡기고 어디서 사람이 멈춰 세울지를 먼저 정하자는 것이었습니다.
레일 아래에는 이어진 데이터가 있어야 합니다
같은 날 오후 들은 Twilio 세션은 레일에 필요한 것이 하나 더 있다고 말했습니다. 제목부터 "AI Won't Save Your CX. Infrastructure Will."이었습니다. AI 상담과 사람 상담원이 같은 고객 맥락을 공유하지 못하면, 아무리 좋은 AI를 붙여도 채널이 바뀔 때마다 대화가 끊깁니다. 레일은 업무 순서만으로 깔리지 않고, AI가 읽을 데이터가 먼저 하나로 이어져 있어야 한다는 이야기였습니다.
아직 다 알지는 못합니다. 다만 한 가지는 분명해졌습니다
솔직하게 말하면, 독일까지 다녀왔다고 AI 마케팅의 정답을 알게 된 건 아닙니다. 무대 위 발표자들도 정답을 말하지는 않았습니다. 다들 실험 중이었고, 그 실험의 규모와 속도를 보며, 이 흐름에서 뒤처지면 안 되겠다는 위기감이 먼저 들었습니다.
돌아보면 이틀간 들은 이야기는 하나로 이어져 있었습니다. 소비자 대신 AI가 브랜드를 고르고, 플랫폼이 자기 성과를 채점하고, 에이전트가 예산을 움직입니다. 세 가지 모두 AI가 한다는 점은 같습니다. 그리고 마케터가 레일을 깔아 두지 않으면, AI 답변 속 노출은 놓치고, 부풀려진 숫자를 믿고 예산을 옮기고, 에이전트 비용은 쌓여 간다는 점도 같습니다.
같은 일을 시켰는데 비용이 30배 차이 난 이유도 결국 여기에 있었습니다. 순서와 멈출 지점이 정해진
레일 위에서는 가장 작은 모델로도 충분했고, 레일이 없으니 가장 비싼 모델이 매번 처음부터 길을
찾아야 했습니다. 차이를 만든 건 AI의 성능이 아니라, 사람이 깔아 둔 레일이었습니다.
AI가 마케팅을 쉽게 만들어 줄 거라고 기대하고 쾰른에 갔습니다. 돌아와 보니 마케터가 해야 할 일은 줄어든 게 아니라, 더 분명해져 있었습니다. AI가 달릴 레일을 까는 일입니다.
돌아와서 점검할 체크리스트
이 글의 내용을 실무에 옮길 때 아티언스가 가장 중요하게 보는 지점은 '사람이 깔아 둔 레일(AI on rails)의 유무'입니다. 단순히 기술 성능에 의존하는 것이 아니라 데이터를 연결하고 결정 단계를 명확히 통제하는 프로세스 설계가 수반되어야 합니다. 자동화 트래픽과 AI 에이전트의 오남용으로 발생하는 비효율을 방지하려면 업무를 단계별로 나누고 검증 기준을 사전에 구축하는 실무 원칙을 세워야 합니다.
또한 본문이 강조하는 'AI 유입과 제3자 측정의 성과 파악' 개념은 마케팅 채널 변화 속에서 숫자의 신뢰성을 확보하기 위한 핵심 기준입니다. AI 플랫폼을 거쳐 들어온 방문자는 높은 전환 가능성을 보이지만, 플랫폼의 자체 리포트나 오염된 신호에만 의존할 경우 왜곡된 최적화가 진행될 수 있습니다. 중립적인 제3자 측정 방식을 도입하고 구체적인 성공 기준을 정의해야만 실제 ROI를 정확히 입증할 수 있습니다.
결국 AI 마케팅 최적화는 '자동화 도구의 전면 도입'이 아니라 '인프라와 프로세스의 엄격한 재정의'에 가깝습니다.
자주 묻는 질문
AI 유입 트래픽은 실제 전환율에 얼마나 영향을 주나요?
Microsoft Clarity 분석에 따르면 AI 플랫폼을 통한 방문 유입의 비중은 아직 전체의 1% 미만이지만, 회원가입 전환율은 1.66%로 일반 검색 유입(0.15%) 대비 10배 이상 높은 것으로 나타났습니다.
ChatGPT 광고의 성과 데이터는 플랫폼 자체 리포트만 믿으면 되나요?
아니요. OpenAI 측에서도 중립적인 성과 비교를 위해 제3자 측정의 필요성을 강조하며 50곳 이상의 파트너사와 연동하고 있으므로 외부 측정 도구를 함께 활용해야 합니다.
구글 AI Max를 사용하면 누구나 전환량이 27% 상승하나요?
아니요. 구글 내부 데이터에 따르면 AI Max 적용 시 평균적인 전환 증가율은 14%이며, 27%는 정확 일치 및 구문 일치 키워드 비중이 높은 특정 캠페인 조건에서 측정된 수치입니다.
마케팅 자동화 및 에이전트 도입 시 비용 폭탄을 피하는 방법은 무엇인가요?
목표만 주고 AI가 판단 경로를 스스로 정하게 하는 방식 대신, 사람이 업무 순서를 미리 정해두는 '워크플로' 방식을 적용하면 가성비 높은 소형 모델을 활용해 실행 비용을 크게 줄일 수 있습니다.
처음 도입할 때 무엇부터 해야 하나요?
에이전트를 도입하기 전에 기존 마케팅 업무를 단계별로 쪼개는 작업부터 시작해야 합니다. 순서가 정해진 반복 단계는 워크플로에 맡기고, 핵심 판단 단계에는 사람이 승인하는 절차를 두어 시스템을 구체화해야 합니다.
참고 자료
- DMEXCO, Scaling Intelligence: DMEXCO's 2026 motto
- Google, Unlock next-level performance with AI Max for Search campaigns (2025.05)
- Microsoft Clarity, AI Traffic Converts at 3x the Rate of Other Channels (2025.11)
- OpenAI, ChatGPT Ads expands to Southeast Asia and Taiwan (2026.09.23)
- HUMAN Security, The 2026 State of AI Traffic & Cyberthreat Benchmark Report