
Artience SEO/GEO 뉴스레터 Vol. 10
검색과 광고에서 AI가 정보를 선택하고 노출하는 방식이 구체화되고 있습니다.
상업성 검색에서 AI Overviews의 노출이 확대되고, OpenAI는 대화 맥락에 따라 ChatGPT 광고를 선택하는 구조를 공개했습니다. Google Discover에서 유용성이 떨어지거나 새 정보로 대체된 콘텐츠를 걸러내는 원리도 소개되면서, 콘텐츠가 어떤 기준으로 선택되고 노출되는지 살펴볼 필요가 있습니다.
크롤러의 접근을 제어하는 robots.txt의 범위와 사용자 요청형 Agent의 특성도 함께 확인해볼 필요가 있습니다. 이번 호에서는 AI 검색과 광고의 노출 구조부터 콘텐츠 선별 기준, AI Agent의 웹 접근 전망까지 다섯 건의 기사로 살펴보겠습니다.
SEO/GEO 주간 브리핑
1. AI Overviews, 상업성 검색 노출 비중 88%로 확대
Source: Luke Harsel, Semrush (원문 보기)
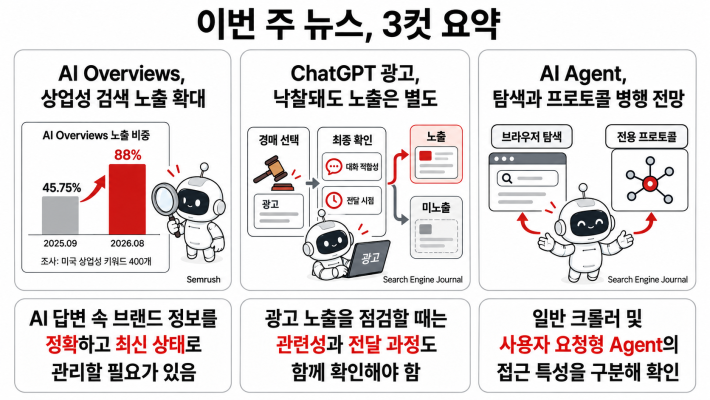
Semrush가 미국에서 상업성 키워드 400개를 분석한 결과, AI Overviews 노출 비중이 2025년 9월 45.75%에서 2026년 8월 88%로 증가했습니다. 가격, 리뷰, 브랜드 비교 등 구매 검토에 쓰이는 검색 유형 전반에서 AI Overviews 노출 비중이 확대되었습니다.
브랜드 비교 및 가격 안내 콘텐츠는 검색 순위와 함께 AI 답변에서 브랜드가 어떻게 언급되는지도 살펴볼 필요가 있습니다. 이번 분석 결과가 전체 검색이나 모든 국가의 노출 비중을 의미하는 것은 아니지만, 핵심 검색어에서 인용되는 자사와 외부 페이지의 제품 정보가 정확한지 확인하고 최신 상태로 관리하는 것이 필요합니다.
#AI Overviews #Commercial Search
2. ChatGPT 광고, 경매에서 선택돼도 노출은 별도 판단
Source: Brooke Osmundson, Search Engine Journal (원문 보기)
OpenAI가 ChatGPT의 광고 선택 구조를 공개했습니다. 회사 설명에 따르면 광고 시스템은 답변 생성과 별도로 작동하며, 대화의 이전 맥락까지 반영해 후보를 찾은 뒤 별도 경매 도구로 순위와 가격을 결정합니다. 하지만 경매에서 낙찰된 광고라도 대화 맥락에 맞지 않거나 답변 전달 시점까지 광고가 준비되지 않으면 노출되지 않을 수 있습니다.
ChatGPT에서 광고 노출이 적을 때는 입찰가뿐 아니라 대화와의 관련성, 노출 자격 및 전달 과정도 함께 살펴봐야 합니다. 다만 원문은 광고주에게 제공되는 내부 진단 정보의 범위와 광고 성과 지표가 충분히 공개되지 않았다고 지적하므로, 구조 설명을 수익성이나 전환 효과의 근거로 받아들이기는 어렵습니다.
#ChatGPT #Ad Auction
3. Google Discover, 오래된 콘텐츠 판별하는 SDF 작동 원리 공개
Source: Roger Montti, Search Engine Journal (원문 보기)
Google Discover에서 오래된 콘텐츠를 걸러내는 SDF(Supersession-Decay Filtering)의 작동 원리가 연구를 통해 공개됐습니다. 이미 약 2년간 운영된 이 시스템은 새 정보로 대체됐거나 시간이 지나 유용성이 떨어진 콘텐츠를 판별해, 순위 산정 단계에 들어가기 전에 추천 후보에서 제외합니다.
원문은 오래 활용할 수 있는 콘텐츠와 유효 기간이 짧은 콘텐츠를 구분하고, 정보가 낡았을 때 갱신할 계획을 마련하도록 제안합니다. 발행일이 최근이라는 이유만으로 신선하다고 보거나 오래된 글을 일괄 제외하기보다, 현재도 유용한 정보인지 확인하는 콘텐츠 관리가 필요합니다.
#Google Discover #Supersession-Decay Filtering
4. Google, robots.txt의 AI 크롤링 통제 범위 설명
Source: Barry Schwartz, Search Engine Roundtable (원문 보기)
Google은 개발자 문서와 영상에서 robots.txt의 지원 규칙과 AI 크롤러 적용 범위를 설명했습니다. robots.txt는 크롤러의 페이지 접근을 제한하는 규약이며, 이미 수집된 콘텐츠의 학습이나 활용 목적까지 정하지는 않습니다. 영어가 아닌 문자와 이모지가 포함된 규칙 경로에는 퍼센트 인코딩을 사용하도록 안내했습니다.
사이트 운영자는 차단하려는 크롤러의 정확한 user-agent 이름과 규칙 문법을 확인하고, 실제 URL이 의도대로 처리되는지 점검해야 합니다. 임의로 쓴 차단 요청이나 잘못된 문법은 무시될 수 있으며, robots.txt는 보안 장치가 아니므로 모든 봇의 접근을 막거나 콘텐츠 이용 제한을 보장하지는 않습니다.
#Google Developers #robots.txt
5. Google CEO, AI Agent의 웹 탐색과 프로토콜 병행 전망
Source: Matt G. Southern, Search Engine Journal (원문 보기)
Google의 CEO인 Sundar Pichai가 AI Agent의 웹 접근 방식으로 브라우저 기반 탐색과 전용 프로토콜을 함께 제시했습니다. 전용 프로토콜은 더 큰 규모로 확장하기에 유리하지만, 여러 기업이 서로 호환되는 표준을 맞추는 데는 시간이 걸릴 것으로 내다봤습니다.
실무에서는 일반 크롤러와 사용자가 요청하는 Agent를 구분해 접근 정책을 점검할 필요가 있습니다. 원문에 따르면 Google-Agent의 경우 사용자 요청형 수집기로 분류돼 대체로 robots.txt 지시를 따르지 않으며, user-agent 문자열도 위조될 수 있어 크롤러 확인 시 공개된 IP 대역을 함께 확인해야 합니다.
#AI Agent #Google-Agent
이번 호에서 확인한 내용은 AI 검색과 광고에서 노출 여부를 넘어, 어떤 정보가 선택되고 어떤 조건에서 제공되는지를 함께 살펴볼 필요가 있음을 보여줍니다. 콘텐츠의 정확성과 유효성을 관리하고, 크롤링 통제 규칙이 실제로 어디까지 적용되는지 구분하는 것이 출발점입니다.
성과를 판단할 때는 조사 범위와 공개된 정보의 한계도 함께 확인해야 합니다. 노출 비중이나 광고 선택 구조만으로 실제 효과를 판단하기는 어려우며, AI Agent의 웹 접근 방식도 현재 확인된 동작과 앞으로의 전망을 구분해 볼 필요가 있습니다. 앞으로도 AI 검색과 광고의 노출 조건부터 콘텐츠 수집과 AI Agent의 접근 방식까지 지속적으로 확인하겠습니다.